Konzept
1. Begriffsklärung
| Begriff | Definition |
|---|---|
| Attribut | aus einem Werkzeugergebnis extrahierte Eigenschaft (bspw. PUID) |
| Attributmenge | alle aus einem Werkzeugergebnis extrahierten Eigenschaften |
| Ergebnismenge | zusammengeführte Attributmengen, die ein Dateiergebnis repräsentieren |
| Gesamtergebnis | die von Borg am höchsten bewertete Ergebnismenge |
| Werkzeug | Programm für die Formaterkennung, -validierung oder Metadatenextraktion |
| Werkzeugausgaben | unverarbeite Ausgaben der Werkzeuge |
2. Ablauf der Formatverifikation
Die Formatverifikation mit Borg erfolgt nach dem folgenden Ablauf:
- Ein Client übermittelt eine Datei zur Formatverifikation an Borg.
- Borg führt alle formatunabhängigen Werkzeuge aus und übermittelt ihnen die Datei zur Analyse.
- Die Werkzeuge analysieren die Datei, extrahieren Metadaten (s. 5. Extraktion von Attributen) und übermitteln ihre Ergebnisse an Borg.
- Auf Grundlage der Erkennungsergebnisse wählt Borg weitere Werkzeuge aus (s. 3. Werkzeugauswahl).
- Borg führt die ausgewählten spezialisierten Werkzeuge aus.
- Die Werkzeuge analysieren die Datei, extrahieren Metadaten (s. 5. Extraktion von Attributen) und übermitteln ihre Ergebnisse an Borg.
- Borg führt die Ergebnisse der aller Werkzeuge zusammen (s. 7. Vereinigung von Attributmengen).
- Borg bewertet die zusammengeführten Ergebnisse (s. 8. Bewertung von Ergebnismengen).
- Das am besten bewertete Ergebnis wird als Gesamtergebnis festgelegt.
- Borg übermittelt das Gesamtergebnis, die extrahierten Metadaten, sowie die Originalausgaben Ausgaben der Werkzeuge an den Client.
---
config:
  theme: redux-color
---
sequenceDiagram
  autonumber
  actor Client
  Client->>Borg: identifiziere Datei
  Borg->>Erkennungswerkzeug: identifiziere Datei
  Erkennungswerkzeug->>Borg: PUID, MIME-Type, Formatversion
  Borg->>Borg: Werkzeugauswahl
  Borg->>Validator: validiere Datei
  Validator->>Borg: PUID, MIME-Type, Formatversion, Validierung
  Borg->>Borg: Vereinigung von Attributmengen
  Borg->>Borg: Bewertung von Ergebnismengen
  Borg->>Borg: Auswahl Gesamtergebnis
Borg->>Client: Dateiformat, Metadaten3. Werkzeugauswahl
Für jede Datei werden alle geeigneten Werkzeuge ausgeführt. Dabei wird zwischen formatunabhängigen und spezialisierten Werkzeugen unterschieden. Formatunabhängige Werkzeuge werden für alle Dateitypen eingesetzt (insb. Formaterkennungswerkzeuge), während spezialisierte Werkzeuge nur für eine Auswahl von Dateiformaten Informationen ermitteln können (insb. Validatoren).
Die Werkzeugausführung erfolgt in zwei Phasen: Zunächst werden die formatunabhängigen Werkzeuge ausgeführt. Anschließend wird anhand ihrer Ergebnisse ermittelt, welche spezialisierten Werkzeuge ausgeführt werden. Die von den formatunabhängigen Werkzeugen ermittelten Attribute können als Bedingung für die spezialisierten Werkzeuge verwendet werden. Die Ausführungsbedingung gilt als erfüllt, sobald ein beliebiges formatunabhängiges Werkzeug die hierfür erforderlichen Ergebnisse ermittelt, unabhängig von ggf. widersprüchlichen Ergebnissen anderer Werkzeuge. Die Ergebnisse der formatunabhängigen Werkzeuge werden dementsprechend zu diesem Zeitpunkt nicht zusammengeführt.
id: "verapdf_1b"
enabled: true
title: "veraPDF (PDF/A-1b-Profil)"
endpoint: "http://verapdf/validate/1b"
triggers:
  - conditions:
      - feature: "format:version"
        regEx: "PDF/A-1b"
  - conditions:
      - feature: "format:puid"
        regEx: "^fmt/354$" # PDF/A-1b
4. Werkzeugausgaben
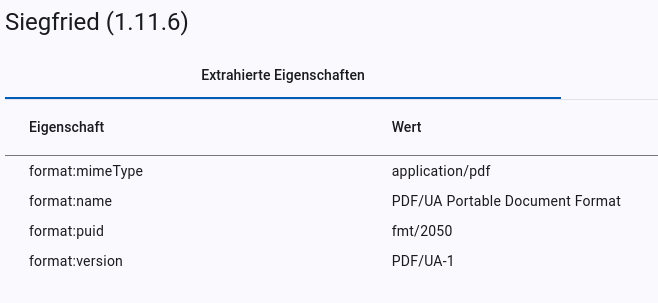
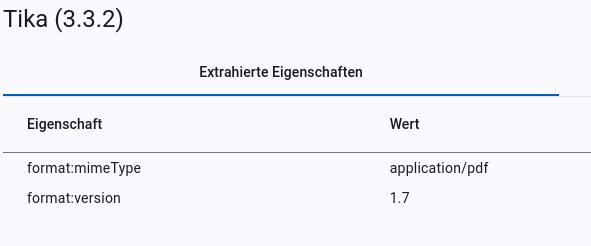
Die Werkzeugausgaben sind sehr heterogen (s. Vergleich Abb. 3 und 4). Eine simple Zusammenführung ist initial ohne weitere Verarbeitungsschritte nicht möglich.
{
  "filename": "e077dbcb-2b5c-41c8-810b-8a69d5c47fbf_Information_Anfragen_und_Benutzer-20.10.23.pdf",
  "filesize": 179666,
  "modified": "2026-09-09T06:55:13Z",
  "errors": "",
  "matches": [
    {
      "ns": "pronom",
      "id": "fmt/2050",
      "format": "PDF/UA Portable Document Format",
      "version": "1",
      "mime": "application/pdf",
      "class": "Page Description",
      "basis": "extension match pdf; byte match at [[0 8] [170470 30]]",
      "warning": ""
    }
  ]
}
{
  "pdf:PDFVersion": "1.7",
  "xmp:CreatorTool": "Microsoft® Word 2019",
  "pdf:docinfo:title": "Informationen zum Umgang mit personenbezogenen Daten gemäß Artikel 12 Datenschutz-Grundverordnung",
  "pdf:hasXFA": "false",
  "dc:format": "application/pdf; version=1.7",
  "pdf:docinfo:creator_tool": "Microsoft® Word 2019",
  "access_permission:fill_in_form": "true",
  "pdf:hasCollection": "false",
  "pdf:encrypted": "false",
  "dc:title": "Informationen zum Umgang mit personenbezogenen Daten gemäß Artikel 12 Datenschutz-Grundverordnung",
  ...
}
5. Extraktion von Attributen
Um eine Vergleichbarkeit der Ergebnisse zu ermöglichen, müssen geeignete Attribute aus der Attributmenge extrahiert werden (s. Abb. 5 und 6). Attribute eignen sich besonders für die Verknüpfung von Werkzeugausgaben, wenn die Werte sich über mehrere Werkzeuge gleichen. Ein Beispiel für ein sehr gut geeignetes Attribut ist die PUID. Diese sollte über alle Werkzeugergebnisse, wenn das gleiche Format erkannt wurde, identisch sein. Der MIME-Type ist relativ gut geeignet. Die Werkzeuge liefern häufig zumindest ähnliche Werte für den MIME-Type. Auch wenn gelegentlich kleinere Abweichungen auftreten, sollte zumindest der Subtyp übereinstimmen. Beispielsweise sind für PDF-Dateien sowohl text/pdf, als auch application/pdf mögliche Werte. Der Formatname ist für den Vergleich von Werkzeugausgaben überhaupt nicht geeignet. Dieser unterscheidet sich in allen Werkzeugen.
6. Vereinigung auf Attributebene
Um ein Gesamtergebnis zu ermitteln, müssen die von den verschiedenen Werkzeugen extrahierten Attributwerte sinnvoll zusammengeführt werden. Im einfachsten Fall liefern alle Werkzeuge für dasselbe Attribut denselben Wert. Die zentrale Frage ist jedoch, wie mit unterschiedlichen Werten umgegangen werden soll.
Eine Methode besteht darin, einen Wert auszuwählen und dabei bestimmte Werkzeuge für einzelne Attribute zu bevorzugen. So könnte beispielsweise grundsätzlich der von DROID ermittelte MIME-Type übernommen werden. Liefert DROID keinen Wert, könnte stattdessen das Ergebnis von JHOVE herangezogen werden. Der Nachteil dieser Methode besteht darin, dass stets das priorisierte Werkzeug ausschlaggebend ist, selbst dann, wenn mehrere andere Werkzeuge denselben abweichenden Wert ermittelt haben.
Um diesem Problem entgegenzuwirken, können die Werkzeuge über die von ihnen ermittelten Werte abstimmen. Dadurch kann die Mehrheit die Entscheidung eines einzelnen Werkzeugs überstimmen. Zusätzlich können die Werkzeuge unterschiedlich gewichtet werden, sodass sie nicht alle gleichermaßen in das Gesamtergebnis eingehen. Diese Methode hat jedoch die Schwäche, dass theoretisch nicht zusammengehörige Attributwerte in das Gesamtergebnis einfließen können. So könnte beispielsweise eine PUID ermittelt werden, die nicht zum festgestellten MIME-Type passt.
Diesem Problem kann begegnet werden, indem alle von den Werkzeugen extrahierten Eigenschaften als untrennbare Einheit betrachtet werden.
7. Vereinigung von Attributmengen
Statt zu versuchen Werkzeugergebnisse auf Attributebene zusammenzuführen, werden die Attributmengen (Menge aller extrahierten Attribute von einem Werkzeug) der Werkzeuge zusammengeführt, wenn davon auszugehen ist, dass die Werkzeuge das gleiche Dateiformat ermittelt haben. Dafür werden für jedes Werkzeug Bedingungen festgelegt, wann die eigene Attributmenge mit einer anderen zusammengeführt werden kann. Wenn eine Bedingung nicht erfüllt wird, können die Attributmengen nicht vereinigt werden. Die Bedingungen werden beidseitig geprüft. Das bedeutet, dass beide Attributmengen die Bedingung der anderen erfüllen müssen. Besitzt eine Attributmenge das Attribut für eine Bedingung nicht, so gilt die Bedingung als erfüllt. Beispielsweise werden für Siegfried 3 Bedingungen konfiguriert (s. Abb. 7), damit die Attributmenge mit einer anderen vereinigt werden kann.
  - id: "siegfried"
    enabled: true
    title: "Siegfried"
    endpoint: "http://siegfried/identify"
    featureSet:
      features:
        - key: "format:puid"
          mergeCondition:
            exactMatch: true
        - key: "format:mimeType"
          mergeCondition:
            valueRegEx: "^[^/]+/(.+)$" # extracts the second part of the MIME type
        - key: "format:version"
          mergeCondition:
            exactMatch: true
        - key: "format:name"
          mergeOrder: 1
      weight:
        default: 0.75
Bedingungen für die Vereinigung mit Siegfried
- PUID muss exakt identisch sein
- Subtype des MIME-Types muss identisch sein (application/pdf --> pdf)
- Formatversion muss exakt identisch sein
1. Beispiel Vereinigung ist möglich
graph LR
  A[Siegfried] --> B((fmt/478));
  A[Siegfried] --> C((application/pdf));
  A[Siegfried] --> D((PDF/A-2u));
  A[Siegfried] <--> E((Tika));
  E[Tika] --> F((text/pdf));
  E[Tika] --> G((Dokumententitel));
  H[Vereinigung] --> I((fmt/478));
  H[Vereinigung] --> J((application/pdf));
  H[Vereinigung] --> K((PDF/A-2u));
  H[Vereinigung] --> L((Dokumententitel));

  classDef mimetype fill:#FFBE91,stroke:#FFBE91
  classDef puid fill:#FFDDB0,stroke:#FFDDB0
  classDef version fill:#FFFCE1,stroke:#FFFCE1
  classDef title fill:#FFEDB9,stroke:#FFEDB9
  classDef tool fill:#CFEBFF,stroke:#CFEBFF

  class B puid
  class I puid
  class C mimetype
  class F mimetype
  class J mimetype
  class D version
  class K version
  class A tool
  class E tool
  class H tool
  class G title
  class L title
2. Beispiel Vereinigung ist NICHT möglich
graph LR
  A[Siegfried] --> B((fmt/478));
  A[Siegfried] --> C((application/pdf));
  A[Siegfried] --> D((PDF/A-2u));
  E[DROID] --> F((fmt/477));
  E[DROID] --> G((application/pdf));
  E[DROID] --> H((PDF/A-2b));

  classDef mimetype fill:#FFBE91,stroke:#FFBE91
  classDef puid fill:#FFDDB0,stroke:#FFDDB0
  classDef version fill:#FFFCE1,stroke:#FFFCE1
  classDef tool fill:#CFEBFF,stroke:#CFEBFF

  class B puid
  class F puid
  class C mimetype
  class G mimetype
  class D version
  class H version
  class A tool
  class E tool
Die Attributmengen aller Werkzeuge werden nacheinander miteinander vereinigt. Die hinzugefügte Attributmenge überschreibt dabei alle Werte der bisherigen Vereinigung. Es können Ausnahmen festgelegt werden, wenn der originale Wert bei er Vereinigung bestehen bleiben soll. In der Standardkonfiguration von DROID und Siegfried wird bspw. festgelegt, dass der Formatname von diesen Werkzeugen bei der Vereinigung erhalten bleiben soll, weil die Qualität des Attributs bei diesen Werkzeugen besser ist.
Formatvalidatoren extrahieren oft keine eigenen Formatattribute. Um die Attributmengen der Validatoren mit denen der Erkennungswerkzeuge vereinigen zu können, werden die Attributmengen der Validatoren angereichert. Diesen Mengen werden Formateigenschaften für das validierte Dateiformat hinzugefügt.
Am Ende entstehen eine oder mehrere Ergebnismengen. Mehrere Ergebnismengen entstehen, wenn nicht alle Attributmengen miteinander vereinigt werden können. In dem Fall ist davon auszugehen, dass die Werkzeuge unterschiedliche Formate erkannt haben (s. Abb. 8).

8. Bewertung von Ergebnismengen
Um ein Gesamtergebnis auswählen zu können, wenn es mehrere Ergebnismengen bzw. erkannte Dateiformate gibt, wird für jede Ergebnismenge eine Bewertung berechnet. Qualitativere Ergebnisse sollen entsprechend besser bewertet werden. Jedes Werkzeug stimmt dafür mit einer festgelegten Gewichtung für alle Ergebnismengen mit denen die eigenen Attributmengen vereinigt wurde. Die Ergebnismenge mit der höchsten Bewertung wird zum Gesamtergebnis. Für jedes Werkzeug kann eine Standardgewichtung und beliebig viele bedingte Gewichtungen definiert werden.
Bedingte Gewichtung
Für Validatoren wird eine Standardgewichtung von 0.0 und eine bedingte Gewichtung von 1.0, falls das Ergebnis valide ist, definiert (s. Abb. 9). Ein negative Validierung, hat wenig Aussagekraft über die geprüfte Datei, eine positive ist hingegen eine Garantie, dass das Dateiformat korrekt erkannt wurde.
  - id: "verapdf_1a"
      weight:
        default: 0.0
        conditional:
          - value: 1.0
            conditions:
              - feature: "format:valid"
                value: true
Bindungsstärke
Bei der Vereinigung von Attributmengen, werden die Gewichtungen addiert. Es ist aber nicht sinnvoll, dass die Attributmenge, die hinzukommt, immer mit der vollen Gewichtung integriert wird. Attributmengen, die die Bedingungen für eine Vereinigung nicht erfüllen können, weil die geforderten Attribute nicht enthalten sind, werden trotzdem vereinigt. Es würde das Ergebnis aber verfälschen, wenn sich dadurch die Bewertung der vereinigten Attributmenge verbessert. Manche Werkzeuge extrahieren nur wenig Format-spezifische Attribute. Magika kann beispielsweise nur den MIME-Type erkennen. Auch hier wäre es verfälschend, wenn die Magika-Gewichtung vollständig, in die Bewertung der Attributmenge eingeht, nur weil der MIME-Type identisch ist. Im Vergleich ist die Attributmenge eines Validators viel aussagekräftiger für die Bewertung, wenn bspw. PUID, MIME-Type, Formatversion und Validierung enthalten sind.
Das Konzept der Bindungsstärke soll diesem Problem entgegenwirken. Die zugrunde liegende Idee besteht darin, dass ähnliche Ergebnismengen viele gemeinsame Attribute aufweisen. Im Anwendungskontext wird dies durch die bei der Vereinigung erfüllten Bedingungen ausgedrückt. Jede erfüllte Bedingung erhöht die Bindungsstärke zwischen den Attributmengen. Mit zunehmender Bindungsstärke steigt der Einfluss der integrierten Attributmenge auf die Bewertung.
Berechnung der Bewertung
| Symbol | Bedeutung |
|---|---|
| \(A_i\) | einzelne Attributmenge |
| \(E_i\) | einzelne Ergebnismenge |
| \(G_{\text{w}}\) | Gewichtung des Werkzeugs einer Attributmenge |
| \(n_i\) | Anzahl der erfüllten Bedingungen für die Vereinigung der Attributsmengen |
| \(\mathcal{A}_{\text{vereinigt}}\) | Menge der für das Ergebnis vereinigten Attributmengen |
| \(G(A_{\text{i}})\) | Gewichtung einer Attributmenge |
| \(B(E_{\text{i}})\) | Bewertung einer Ergebnismenge |
| \(B_{\text{norm}}\) | normalisierte Bewertung einer Ergebnismenge im Intervall von 0 bis 1 |
1. Berechnung der Gewichtung einer Attributsmenge
2. Berechnung der Bewertung einer Ergebnismenge
3. Berechnung der normalisierten Bewertung einer Ergebnismenge
Überschreiben der Bewertung
Es gibt Fälle, in denen die berechnete Bewertung nicht den Erwartungen entspricht. Es ist nicht ungewöhnlich, dass eine Datei gleichzeitig die Anforderungen mehrerer Dateiformate erfüllt. Eine valide PDF/UA-Datei (ISO 32000-1) ist beispielsweise immer auch eine valide PDF-1.7-Datei. Borg erkennt in diesem Fall beide Dateiformate (s. Abb. 9).
Die meisten Werkzeuge erkennen PDF-1.7, nicht jedoch PDF/UA, als Dateiformat. Daher fällt die Bewertung der Ergebnismenge für PDF-1.7 höher aus als diejenige für PDF/UA. Um solche Sonderfälle zu behandeln, können Bedingungen zum Überschreiben der Bewertung definiert werden. Sind die Bedingungen für eine Ergebnismenge erfüllt, wird deren Bewertung auf 1,0 angehoben. Die Bewertungen der übrigen Ergebnismengen werden entsprechend auf 0,0 gesetzt. Um PDF/UA aufzuwerten wird zwei Bedingungen für die Ergebnismenge definiert (s. Abb. 10):
- Die Ergebnismenge muss die Formatversion PDF/UA enthalten.
- Ein Validator muss das Dateiformat bestätigt haben.
Wenn beide Bedingungen erfüllt sind, wird die Ergebnismenge „PDF 1.7“ mit 0,0 bewertet, während die Ergebnismenge „PDF/UA“ eine Bewertung von 1,0 erhält.
fileIdentity:
  - conditions:
      - feature: "format:version"
        value: "PDF/UA"
      - feature: "format:valid"
        value: true